基于RISC-V的人工智能应用开发 开源架构如何重塑AI软件生态
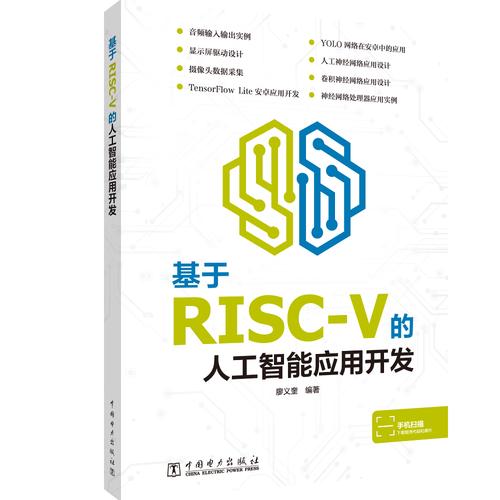
引言\n\n人工智能应用软件正以前所未有的速度渗透到各行各业,从智能语音助手到自动驾驶决策系统,其背后都离不开底层计算架构的支撑。长期以来,x86与ARM架构主导了AI计算市场,但一种开放、灵活且可扩展的指令集架构——RISC-V——正在悄然改变这一格局。RISC-V不仅为AI芯片设计提供了自由度,更对人工智能应用软件开发范式产生了深远影响。本文将探讨基于RISC-V架构进行AI应用开发的核心优势、关键技术栈、典型开发流程以及面临的挑战与未来趋势。\n\n## 一、RISC-V为AI应用开发带来的独特价值\n\n### 1.1 开放指令集与定制化扩展\n\nRISC-V最显著的特征是其开源开放特性。开发者可以自由实现基础指令集,并根据AI工作负载的特点添加自定义扩展指令。例如,针对矩阵乘法、卷积运算或激活函数,可以设计专用的向量扩展(如RISC-V V扩展)或自定义加速指令。这意味着AI应用软件开发者能够针对特定模型(如Transformer、CNN)进行底层优化,获得比通用处理器更高的能效比。\n\n### 1.2 异构计算与领域专用架构\n\nAI应用往往涉及异构计算——CPU负责控制流,GPU/NPU负责密集计算。RISC-V可作为主控核或协处理核,灵活集成到SoC中。开发者可以基于RISC-V构建领域专用架构(DSA),将AI算子硬件化。在软件层面,这要求开发者理解如何利用RISC-V的定制指令集进行算子卸载与任务调度,从而编写出高度协同的AI应用代码。\n\n### 1.3 软件栈的开放性与可移植性\n\nRISC-V拥有日益完善的软件生态,包括GCC/LLVM编译器、Linux内核、TensorFlow Lite、PyTorch(通过TVM等中间表示)的支持。开发者可以使用标准C/C++、Python进行AI应用开发,并通过RISC-V工具链编译到目标硬件。开源的特性降低了厂商锁定风险,便于代码复用与跨平台迁移。\n\n## 二、基于RISC-V的AI应用软件开发关键技术栈\n\n### 2.1 操作系统与运行时环境\n\n在RISC-V上开发AI应用,通常选择Linux作为主操作系统(适用于应用处理器场景),或FreeRTOS/Zephyr(适用于微控制器场景)。运行时环境需支持POSIX接口,并针对内存受限环境优化。例如,针对边缘AI设备,可使用轻量级容器(如Docker for RISC-V)或WebAssembly运行时来部署模型推理服务。\n\n### 2.2 AI推理框架与编译优化\n\n主流AI框架已开始支持RISC-V后端。TensorFlow Lite for RISC-V通过XNNPACK库提供优化算子;Apache TVM则可将深度学习模型编译为RISC-V机器码,并利用自动调优(AutoTVM/Ansor)针对特定RISC-V核生成高效内核。MLIR(多级中间表示)生态系统正在成为连接高层框架与RISC-V硬件的重要桥梁,允许开发者定义自定义方言以映射到RISC-V向量指令。\n\n### 2.3 算子库与数学库\n\n针对RISC-V的AI应用开发,需要高性能算子库支持。例如,OpenBLAS已提供RISC-V端口,支持基础线性代数运算;oneDNN(原MKL-DNN)也在逐步增加RISC-V支持。对于自定义加速器,开发者需编写针对RISC-V自定义指令的内联汇编或Intrinsic函数,实现卷积、池化、归一化等核心算子。\n\n### 2.4 性能分析与调试工具\n\nRISC-V生态提供了GDB、OpenOCD、perf等工具,支持AI应用的性能剖析。开发者可利用RISC-V追踪模块(如Processor Trace)分析指令级行为,结合AI框架的profiling工具(如TensorBoard)定位算子瓶颈。QEMU模拟器可用于早期软件开发与功能验证,加速迭代周期。\n\n## 三、AI应用软件开发流程与最佳实践\n\n### 3.1 需求分析与架构选型\n\n首先明确AI应用场景:是云端训练推理、边缘推理还是端侧TinyML?根据算力、功耗、成本约束选择合适的RISC-V核配置(如单核RV32IMC、多核RV64GC、带向量扩展的RV64GCV)。同时评估是否需要集成NPU或DSP协处理器。\n\n### 3.2 模型训练与转换\n\nAI应用开发通常在x86/GPU服务器上完成模型训练,然后通过量化(如INT8)、剪枝、知识蒸馏等技术压缩模型。之后使用模型转换工具(如TFLite Converter、ONNX至RISC-V后端)将模型转为适合目标硬件的格式(如FlatBuffer、TVM Relay IR)。\n\n### 3.3 目标平台适配与优化\n\n将转换后的模型部署到RISC-V平台。此阶段重点包括:\n- 内存布局优化:针对RISC-V缓存层次调整张量排列。\n- 算子映射:将模型算子映射到RISC-V向量指令或自定义加速指令。\n- 并行化:利用RISC-V多核或超线程(如支持)进行任务分割。\n- 自动化调优:使用TVM Autoscheduler或类似工具搜索最优调度方案。\n\n### 3.4 测试与验证\n\n在RISC-V硬件或模拟器上运行功能测试,验证推理精度。利用差分测试(与x86结果对比)确保数值一致性。性能测试应关注延迟、吞吐量、能效比(如TOPS/W)。安全测试需验证内存隔离(如RISC-V PMP机制)与模型健壮性。\n\n### 3.5 持续集成与部署\n\n建立基于RISC-V的CI/CD流水线,包括交叉编译、QEMU模拟测试和硬件在环测试。对于边缘设备,采用OTA更新机制部署模型与软件补丁。\n\n## 四、应用案例:智能视觉边缘计算\n\n假设开发一款基于RISC-V的智能摄像头应用,实现实时人脸检测。硬件选用集成RV64GC双核与NPU的SoC。软件开发流程如下:\n1. 在PC上使用PyTorch训练轻量级人脸检测模型(如MobileFaceNet),并量化为INT8。\n2. 使用TVM将模型编译为RISC-V+NPU异构代码,CNN层运行于NPU,后处理运行于RISC-V CPU。\n3. 编写C++应用主程序,调用V4L2接口获取摄像头数据,使用RISC-V向量扩展加速图像预处理(如色彩转换、缩放)。\n4. 利用RISC-V核间通信机制(如OpenAMP)协调NPU与CPU任务。\n5. 通过perf与自定义计数器分析推理流水线,优化内存拷贝与算子融合。\n6. 部署至设备,实现每秒30帧的实时检测,功耗低于2W。\n\n## 五、挑战与应对策略\n\n### 5.1 软件生态碎片化\n\nRISC-V硬件实现多样,导致软件移植面临兼容性挑战(如自定义扩展不一致)。应对策略:优先采用RISC-V标准扩展(如V扩展、Zfinx),并使用可移植抽象层(如RISC-V统一ABI)。参与RISC-V国际基金会软件工作组,推动标准统一。\n\n### 5.2 性能优化复杂度高\n\n手动利用自定义指令优化AI算子对开发者要求极高。应对策略:采用领域专用编译器(如MLIR+RISC-V Dialect),通过高层次抽象自动生成优化代码;或使用现成算子库与自动调优框架。
5.3 调试与性能分析工具有待完善
相比ARM/x86,RISC-V调试工具在系统级追踪与功耗分析方面仍有差距。应对策略:结合开源工具链与商用解决方案(如Segger J-Link、Lauterbach TRACE32对RISC-V的支持),并积极参与开源社区共建。
5.4 人才储备不足
熟悉RISC-V与AI交叉领域的开发者相对稀缺。应对策略:高校开设RISC-V与边缘AI课程;企业提供基于RISC-V开发板的实战培训;社区组织开源项目贡献(如RISC-V AI算子优化)。
六、未来展望
RISC-V在AI应用软件开发领域的前景广阔。随着RISC-V向量扩展的成熟和矩阵扩展的标准化,AI软件将能更高效地利用硬件并行性。RISC-V与RISC-V AI加速器的深度融合将催生更紧凑的软件栈。基于RISC-V的Server级芯片(如Ventana Veyron)有望支撑云端AI推理软件开发,打破生态垄断。长远来看,开源软件定义硬件的理念将激励更多AI应用开发者深入底层优化,形成软硬件协同创新的良性循环。
##
基于RISC-V的人工智能应用开发正处于爆发前夜。开放的指令集赋予了软件开发者前所未有的硬件控制权,而不断完善的软件生态则降低了准入门槛。无论是边缘智能还是云端推理,RISC-V都有潜力成为AI应用软件的重要运行平台。对于开发者而言,拥抱RISC-V不仅是技术选择,更是参与塑造开放AI计算未来的机遇。通过充分利用RISC-V的定制化能力与繁荣的开源工具链,我们能够开发出更高能效、更灵活的AI应用软件,推动人工智能真正走向普惠与无处不在。
如若转载,请注明出处:http://www.gzyssb.com/product/40.html
更新时间:2026-10-24 14:32:43